A kísérleti elrendezés és a döntési helyzetek kialakítása
1. Bevezető
A matematikát több diák nehéz tantárgynak tartja és ehhez számos sztereotípiát kapcsol. Úgy véli, hogy a matematikai képesség veleszületett adottság és nem fejleszthető, így aki „nem született matematikusnak”, az soha nem fogja igazán megérteni a tantárgyat [8, 25].
A hallgatók gyakran nem látják az egyetemi tananyag és a saját szakterületük közötti összefüggéseket, többen úgy érezhetik, hogy a matematika csupán egy szükséges, elkerülhetetlen akadály, amit teljesíteniük kell ahhoz, hogy befejezhessék tanulmányaikat [1]. Ennek következtében a motiváció gyakran alacsony, és a matematikai problémák megoldásának folyamata nem kapja meg a megfelelő figyelmet [28]. A hallgatók egy része, ahelyett, hogy a tanulmányai első éveiben az alapvető összefüggések és fogalmak elsajátítására koncentrálna, inkább a gyakorlati feladatok megoldásával kezdene. Ehhez pedig elengedhetetlen egy alkalmas matematikai modell felállítása, ami nem triviális feladat. Ezt támasztja alá a [14, 16] cikkek tapasztalata. A szerzők azt találták, hogy az alapképzésben résztvevő STEM-hallgatók az alkalmazásorientált feladatok helyett a tiszta matematikai feladatokat részesítették előnyben. Ennek a preferenciának az egyik fő oka az volt, hogy a diákok a tiszta matematikai feladatokat könnyebben megoldhatónak tartották, mint az alkalmazási feladatokat.
Egy alkalmazási probléma megoldásához szükséges matematikai modell alkotására való készséget a koncepciók és az elmélet megértésére való összpontosítás támogathatja. Ez hosszú távon elősegíti a mélyebb tudás megszerzését [4]. Hatékonyan hozzájárul ahhoz, hogy a hallgatók képesek legyenek átlátni a matematika és a gazdasági elemzés, a mérnöki feladatok, a természettudományos jelenségek, az informatika közötti kapcsolatokat, valamint hogy a tanultakat alkalmazni tudják a saját szakterületükön. Problémát okozhat, ha egy hallgató a feladatok mechanikus megoldására koncentrál, a valódi megértés helyett csupán a kurzusok teljesítésére összpontosít [26]. Ez a későbbiekben hátráltathatja a komplexebb problémák kezelésére való készségét. A motivációs problémák és az elméleti alapok megértésének hiánya hosszú távon a tudásfelhalmozás akadályává válhat, és megnehezíti a matematikai módszerek hatékony alkalmazását a jövőbeli szakmai életükben.
Célul tűztük ki, hogy megtudjuk miként lehetne az egyetemi hallgatók számára vonzóbbá tenni a matematikát és a matematikán alapuló tantárgyak elsajátítását, azáltal, hogy megkérdezzük őket, mely kurzusjellemzők járulnak legnagyobb mértékben ahhoz, hogy szívesen és eredményesen tanulják ezeket a tantárgyakat.
A preferenciák vizsgálata érdekében a diszkrét választási kísérlet (discrete choice experiment – DCE) módszert alkalmazzuk, amelyet széles körben használnak a közgazdaságtanban és a társadalomtudományokban, hogy megértsék az egyének döntéseit véges számú opcióból álló döntési halmazok esetén.
A DCE-t a gazdasági elemzések mellett az oktatásgazdaságtani kutatásokban is alkalmazzák a felsőoktatási preferenciák és az oktatási módszerek feltárására. A [7] publikációban a szerzők orvostanhallgatók körében alkalmazták a DCE-t a probléma-alapú oktatás preferenciájának modellezésére. A [15] szakirodalomban közgazdaságtani hallgatók körében azt vizsgálták, hogyan preferálják az elkészített feladatokra az oktató által adott visszajelzést vagy azok benyújtásának módját és ezeknek a hatását a vizsgára való felkészülésre.
Bár a felsőoktatási preferenciákkal foglalkoznak kutatások, a matematikakurzusok sajátos szempontjai, valamint a különböző képzési területek közötti eltérések eddig kevesebb figyelmet kaptak. A kutatásunkban a DCE módszertanát a matematikaoktatás kontextusára alkalmazzuk, feltárva a különböző szakos hallgatók preferenciáit.
Jelen cikkünkben – amely egy kétrészes tanulmány I. része – a DCE elméleti és módszertani alapjait, valamint a kutatás előkészítését mutatjuk be. Ennek megfelelően az alábbiakban először az alkalmazott módszertan elméleti hátterét és a paraméterek becslésének matematikai alapjait ismertetjük. Ezt követően részletesen felvezetjük a vizsgált matematikakurzusra vonatkozó döntési helyzetek alternatíváit, azok attribútumait és szintjeit, valamint a kérdőív felépítését.
A kísérletből származó empirikus eredményeket, valamint az azokból levonható oktatásmódszertani tanulságokat a tanulmány II. részében tárgyaljuk.
2. Módszer
2.1 Alkalmazott módszertan
A DCE során a döntéshozókat arra kérjük, hogy válasszanak egy alternatívákból álló halmazból, hogy információt nyerjünk a preferenciáikról. A modellezése általában a véletlenszerű hasznosságmaximalizálás (random utility maximization – RUM) [18] keretrendszer alapján történik. A RUM keretrendszer szerint a döntéshozó a rendelkezésére álló alternatívák közül azt választja, amely számára a legnagyobb hasznosságot biztosítja. A hasznosság azonban a kutató számára nem figyelhető meg teljes egészében, ezért a modell azt egy szisztematikus és egy véletlen komponensre bontja. A szisztematikus komponens az alternatívák megfigyelhető jellemzőihez, például az attribútumok szintjeihez kapcsolódik, míg a véletlen komponens a nem megfigyelt tényezőket és a választási helyzetben megjelenő bizonytalanságot ragadja meg. A diszkrét választási kísérletekben ez a megközelítés Lancaster karakterisztikaelméletével egészül ki, amely szerint az alternatívák hasznossága nem önmagukból az alternatívákból, hanem azok tulajdonságaiból származik. Ennek megfelelően a válaszadók olyan választási helyzetekben döntenek, ahol az alternatívák különböző attribútumszintek kombinációiként jelennek meg. Ebből adódóan egy döntési halmazon belül az \(n\) válaszadónak az \(i\) alternatívából származó hasznossága, \(U_{ni}\), az alábbi egyenlet szerint definiálható: \[\displaystyle U_{ni}=V_{ni}+\varepsilon_{ni}, \] ahol \(V_{ni}\) a hasznosság szisztematikus részét, \(\varepsilon_{ni}\) pedig a hasznosság véletlen komponensét jelöli. A \(V_{ni}\) komponens egy függvény \(V_{ni}=f(x_{ni},\ \beta)\), ahol az \(x_{ni}=(x_{ni1}, \dots, x_{niK})\) vektor az \(i\) alternatívát jellemző tulajdonságokból és az \(n\) válaszadó egyéni tulajdonságaiból felépülő attribútumokat írja le, \(\beta=(\beta_1,\dots,\beta_K)\) pedig a becsülendő paraméterek vektora, amely az attribútumokhoz kapcsolódó preferencia súlyokat adja meg [17]. A RUM modellbecslésben a \(V_{ni}\) egy lineáris kombinációja az attribútumoknak és a becsülendő paramétereknek, azaz \(V_{ni}=\sum_{k=1}^{K}{x_{nik}\cdot\beta_k}\).
Példaként tegyük fel, hogy a választási halmaz az \(i=1\) kerékpár és az \(i=2\) busz alternatívákból áll. Mindkét alternatívát az ár és a teljes utazási idő jellemzői alapján vizsgáljuk. Az (alternatívákra jellemző) hasznossági függvények szisztematikus része tehát a következő alakú: \[\displaystyle V_{n1} = \beta_1\cdot \text{Ár}_1 + \beta_2 \cdot \text{Idő}_1, \quad V_{n2} = \beta_1\cdot \text{Ár}_2 + \beta_2 \cdot \text{Idő}_2. \] Az, hogy mindkét alternatíva esetén ugyanazokat a paramétereket \((\beta_1, \beta_2)\) használjuk, azt jelenti, hogy a hasznosság értékét a válaszadók minden alternatívára azonos módon értékelik. Továbbá a modellnek figyelembe kell vennie azokat a jellemzőket is, amelyeket válaszadóra jellemző vagy szocio-demográfiai tulajdonságoknak nevezünk. Ezek – ellentétben az alternatívára jellemző változókkal – egy adott válaszadó esetében állandóak minden alternatívára nézve, ugyanakkor a válaszadók között változnak. Figyelembe vehető változók például: a kor, a nem, a jövedelem stb. Ha az előző példához hozzáadjuk a nem változót, akkor a következő matematikai összefüggést kapjuk: \[V_{n1}=\beta_1 \cdot \text{Ár}_1 + \beta_2 \cdot \text{Idő}_1+ \beta_{31} \cdot\text{Nem}_n, \quad V_{n2} = \beta_1 \cdot \text{Ár}_2 + \beta_2 \cdot\text{Idő}_2+ \beta_{32} \cdot \text{Nem}_n.\] Feltételezzük, hogy a válaszadó-specifikus változó hatása az alternatívák hasznára eltérő. Ennek következtében szükséges, hogy egy változóhoz (itt: a nemhez) minden alternatívához külön-külön hozzárendeljünk egy-egy koefficienst (\(\beta_{31}\) és \(\beta_{32}\)).
A RUM keretrendszerében egy döntéshozó akkor választ egy adott alternatívát, ha annak hasznossága nagyobb, mint a választási halmazban szereplő többi alternatíváé. Így, annak a valószínűsége, \(P_{ni}\), hogy az \(n\) válaszadó az \(i\) alternatívát választja, a következőképpen adható meg [9]: \[\displaystyle \begin{gather} P_{ni}=P(U_{ni}>U_{nj}\ \ \forall j\neq i)=P\left(V_{ni}+\varepsilon_{ni}>V_{nj}+\varepsilon_{nj}\ \ \forall j\neq i\right)=\\ =P(\varepsilon_{nj}-\varepsilon_{ni}<V_{ni}-V_{nj}\ \ \ \forall j\neq i). \end{gather} \]
Azaz \(P_{ni}\) annak a valószínűsége, hogy a hibatagból származó \(\varepsilon_{nj}-\varepsilon_{ni}\) haszonkülönbség kisebb, mint a szisztematikus haszonkomponensek \(V_{ni}-V_{nj}\) különbsége. Minden \(i\) alternatívára az \(\varepsilon_{ni}\) eloszlását egy \(f({\varepsilon }_{ni})\) sűrűségfüggvény írja le. Feltesszük, hogy létezik egy együttes sűrűségfüggvény \(f(\varepsilon_n)\) úgy, hogy \(\varepsilon_n\) a (\(\varepsilon_{n1},\dots,\varepsilon_{nJ}\)) vektort reprezentálja, ahol \(J\) az alternatívák száma. Ebből adódóan a \(P_{ni}\) valószínűség a következőképpen adható meg: \[\displaystyle P_{ni}=\int_{\varepsilon_n}{I(\varepsilon_{nj}-\varepsilon_{ni}<V_{ni}-V_{nj}\ \forall j\neq i)f(\varepsilon_n)d\varepsilon_n,} \] ahol \(I=1\), ha a zárójelben szereplő kifejezés igaz, egyéb esetekben pedig 0 [24]. A RUM keretrendszerből különböző diszkrét választási modellek vezethetők le. A vizsgálatunkhoz a feltételes logit modellt használjuk, ahol az \({\varepsilon}_{ni}\) hibatag, konstans része beépíthető a szisztematikus hasznosságba, ezért a várható értéke nullára normalizálható [9]. A feltételes logit modellben az \(\varepsilon_{ni}\) hibatagokról azt feltételezzük, hogy minden \(i\) alternatíva és minden \(n\) egyén esetén függetlenek, azonos eloszlásúak és \(I\)-es típusú szélsőérték-eloszlást követnek (a szakirodalomban gyakran iid-jellemzőként hivatkoznak erre [24]. Ezért a sűrűségfüggvényük és az eloszlásfüggvényük: \[\displaystyle f(\varepsilon_{ni})=e^{-\varepsilon_{ni}}e^{-e^{-\varepsilon_{ni}}},\quad F(\varepsilon_{ni})=e^{{-e}^{-\varepsilon_{ni}}}. \]
Ezeket a feltételeket felhasználva a feltételes logit modellben a választási valószínűségre egy egyszerű formulát vezethetünk le. Ha rögzítjük az \({\varepsilon }_{ni}\) hibatagot, akkor a \(P_{ni}|{\varepsilon }_{ni}\) feltételes valószínűségre az iid-tulajdonságból \[\displaystyle \begin{gather} P_{ni}| {\varepsilon }_{ni} =P(\varepsilon_{nj}-\varepsilon_{ni} < V_{ni} -V_{nj} \quad \forall j\neq i)=\\ =\prod_{j \neq i}P(\varepsilon_{nj} < \varepsilon_{ni} + V_{ni}-V_{nj}) = \prod_{j\neq i} F(\varepsilon_{ni} + V_{ni} – V_{nj}), \end{gather} \] adódik. Mivel az \(\varepsilon_{ni}\) nem ismert, a teljes valószínűség tételéből következik \[\displaystyle P_{ni}=\int_{{\varepsilon }_{ni=-\infty}}^{\infty } \prod_{j\neq i}F(\varepsilon_{ni}+V_{ni}-V_{nj})f(\varepsilon_{ni})d{\varepsilon}_{ni}. \]
Az általánosság megszorítása nélkül tegyük fel, hogy \(i=1\). Ekkor \[\displaystyle \begin{aligned} P_{n1} &= \int_{\varepsilon_{n1}=-\infty}^{\infty} \prod_{j \neq 1}F(\varepsilon_{n1} + V_{n1} – V_{nj}) f(\varepsilon_{n1}) \,d\varepsilon_{n1} = \\ &= \int_{-\infty}^{\infty} \prod_{j \neq 1}\exp\left[-e^{-(\varepsilon_{n1} + V_{n1} – V_{nj})}\right]e^{-\varepsilon_{n1}} \exp\left[-e^{-\varepsilon_{n1}}\right]d\varepsilon_{n1} = \\ &= \int_{-\infty}^{\infty} \prod_{j=1}^{J}\exp\left[-e^{-(\varepsilon_{n1} + V_{n1} – V_{nj})}\right]e^{-\varepsilon_{n1}} \, d\varepsilon_{n1} = \\ &= \int_{-\infty}^{\infty} \exp\left(-\sum_{j=1}^{J}e^{-(\varepsilon_{n1} + V_{n1} – V_{nj})}\right) e^{-\varepsilon_{n1}}\, d\varepsilon_{n1} = \\ &= \int_{-\infty}^{\infty} \exp\left(-e^{-\varepsilon_{n1}}\sum_{j=1}^{J} e^{-(V_{n1} – V_{nj})}\right) e^{-\varepsilon_{n1}} \,d\varepsilon_{n1}. \end{aligned} \]
Alkalmazva a \(t=e^{-{\varepsilon }_{n1}}\) helyettesítést, \(dt={-e}^{-{\varepsilon}_{n1}}d{\varepsilon }_{n1}\), az integrálás határai, ha \({\varepsilon }_{n1}=-\infty\), akkor \(t=\infty\), ha \({\varepsilon }_{n1}=\infty\), akkor \(t=0\). Így \[\displaystyle \begin{aligned} P_{n1} &= \int_{\infty}^{0} \exp\left(-t \sum_{j=1}^{J}e^{-\left(V_{n1}-V_{nj}\right)}\right) \left(-dt\right) = \\ %&=\int_{0}^{\infty} \exp\left(-t \sum_{j=1}^{J}e^{-\left(V_{n1}-V_{nj}\right)}\right) dt = \\ &= \left[ \frac{-1}{\sum_{j=1}^{J} e^{-\left(V_{n1}-V_{nj}\right)}}\exp\left(-t \sum_{j=1}^{J} e^{-\left(V_{n1}-V_{nj}\right)}\right)\right]_{0}^{\infty} = \\ &= \frac{1}{\sum_{j=1}^{J} e^{-\left(V_{n1}-V_{nj}\right)}} =\frac{e^{V_{n1}}}{\sum_{j=1}^{J} e^{V_{nj}}}. \end{aligned} \]
Analóg számolással kapjuk minden \(i \in I\) esetén ([9]), hogy \[\displaystyle P_{ni}= P_{ni}(\beta) = \frac{e^{V_{ni}}}{\sum_{j=1}^{J} e^{V_{nj}}} =\frac{e^{\sum_{k=1}^{K} \beta_k x_{nik}}}{\sum_{j=1}^{J}e^{\sum_{k=1}^{K} \beta_k x_{njk}}}. \]
2.2 A paraméterek becslése
A logit modell paramétereinek becsléséhez a maximum likelihood módszert alkalmazzák. A módszer lényege, hogy azokat a paraméterértékeket keressük, amelyek mellett a megfigyelt választások bekövetkezése a legvalószínűbb a modell szerint, azaz a megfigyelt választások valószínűségét maximalizálja. A módszer mögött egy binárisan kódolt véletlen Y változó áll, amely a megfigyelt választási eredményeket prezentálja. \[\displaystyle Y_{ni} =\begin{cases} 1, & \text{ha az } i \text{ alternatíva kiválasztásra kerül az }n \text{ alany által} \\ 0, & \text{ha az } i \text{ alternatíva nem kerül kiválasztásra az }n \text{ alany által} \end{cases} \]
Az \(L(\beta)\) likelihood függvény \(\hat{\beta}\) becsült paraméterei az egyes \(Y_{ni}\) választási döntések függvényében kerülnek meghatározásra minden \(n\) döntéshozó és \(i\) alternatíva esetében [13]. A logit modellben a likelihood függvény a következőképpen határozható meg: \[\displaystyle L(\beta)=\prod_{n=1}^{N}\prod_{i=1}^{J}{(P_{ni}(\beta))}^{Y_{ni}}. \]
A módszer célja az \(L(\beta)\)
függvény értékének maximalizálása. Ez összhangban van a \(\beta\) becsült paraméterek optimális
beállításával az alapul szolgáló adatokhoz. A gyakorlatban a
\[\displaystyle
\ln L(\beta) = \sum_{n=1}^{N} \sum_{i=1}^{J}Y_{ni} \ln P_{ni}(\beta)
\]
log-likelihood függvényt
maximalizáljuk, mert ez számítási szempontból kezelhetőbb miközben
ugyanahhoz az optimumhoz vezet, mint a likelihood függvény
maximalizálása. A paraméterek becslése az Apollo R csomag alkalmazásával
történt ([11], [12], [21]).
Annak megállapítására, hogy milyen mértékben tekinthető a becslési
modell az adathalmazhoz való ésszerű adaptációnak, a
likelihood-arány-teszt is alkalmazható. A nullhipotézis szerint, amikor
az összes együttható nulla értéket vesz fel (ami a null-log-likelihood
\(\ln L(0)\)-nak felel meg), a
statisztika
\[\displaystyle
-2(\ln L(0) – \ln L(\widehat{\beta }))
\]
\({\chi}^{2}\) eloszlású \(K\)
szabadságfokkal, ahol \(K\) a modell
becsült paramétereinek a számát jelöli. A statisztikában az \(L(\widehat{\beta })\) tag a likelihood
függvény maximalizált értékét, az \(\ln{L(0)}\) tag a null modell
log-likelihood értékét jelöli [23].
A \(R^2\) egy olyan modellilleszkedési
mutató, amely azt mutatja meg, hogy a becsült modell mennyivel javítja a
log-likelihood értékét a nullmodellhez képest [9]:
\[\displaystyle
\text{Pszeudo-}R^{2}=1-\frac{lnL(\widehat{\beta})}{lnL(0)}.
\]
A modell elemzéséhez használjuk továbbá az AIC-t (Akaike-féle információs kritériumot): \[\displaystyle \text{AIC}=-2\ln{L(\widehat{\beta})}+2K. \]
A BIC (Bayesi információs kritérium) az AIC-hez hasonlóan egy információs kritérium, amelynek célja, hogy segítsen a modell illeszkedése és a bonyolultsága közötti egyensúly megtalálásában: \[\displaystyle \text{BIC} = -2 \ln L(\widehat{\beta}) + K\cdot \ln(n), \] ahol \(n\) a megfigyelések számát jelöli [20].
2.3 A kutatás folyamata
A kutatási célunk a matematikai oktatással kapcsolatos preferenciák vizsgálata volt, ennek érdekében DCE-t végeztünk. Első lépésben a kísérlet döntési helyzeteinek alternatíváit (esetünkben különböző matematikakurzus opciókat) jellemző attribútumok kiválasztását végeztük el szakirodalmi áttekintés alapján. Arra törekedtünk, hogy korábbi kutatások alapján átfogó képet kapjunk azokról a kurzustényezőkről, amelyek elősegíthetik az egyetemi hallgatók számára a tananyag könnyebb elsajátítását és a jobb vizsgaeredmények elérését. Ezek alapján a következő attribútumokat határoztuk meg: (1) csoport mérete, (2) csoport összetétele, (3) értékelés, (4) oktatás formája, (5) kurzus időtartama, (6) kurzus gyakorisága, (7) oktató korosztálya, (8) oktató neme, (9) pedagógus oktatói tapasztalata, (10) számonkérés formája, (11) számonkérés relevanciája, (12) rendelkezésre álló segédanyag, (13) kurzusok orientációja, valamint (14) kurzus tartalma ([7], [15]).
A kutatásunk következő fázisában az előbbiekben említett 14 attribútummal egy pilot felmérést hajtottunk végre annak érdekében, hogy a tulajdonságok számát redukálni tudjuk. A pilot kutatást a Debreceni Egyetem hallgatói körében végeztük a Természettudományi és Technológiai Kar valamint a Gazdaságtudományi Kar bevonásával. A karok választását egyrészt az indokolja, hogy a képzésükben megjelenik a matematika vagy a matematikán alapuló tantárgyak oktatása. Másrészt a különböző tudományterületek más – más hallgatói preferenciákat képviselnek.
Az előzetes kutatásunk 2024. szeptember 12. és 29. között zajlott, papíralapú és online adatgyűjtési módszerek alkalmazásával. A hallgatók a fent említett 14 szempontot egy 1-től 7-ig terjedő skálán értékelték, ahol az 1-es az „egyáltalán nem járul hozzá”, míg a 7-es a „nagymértékben hozzájárul” értéket jelölte. A hallgatói döntéshozatal megkönnyítése érdekében ahol szükségesnek ítéltük az attribútumokat leírással láttuk el. A pilot felmérés során használt kérdőív elérhető a következő linken: Pilot felmérés.
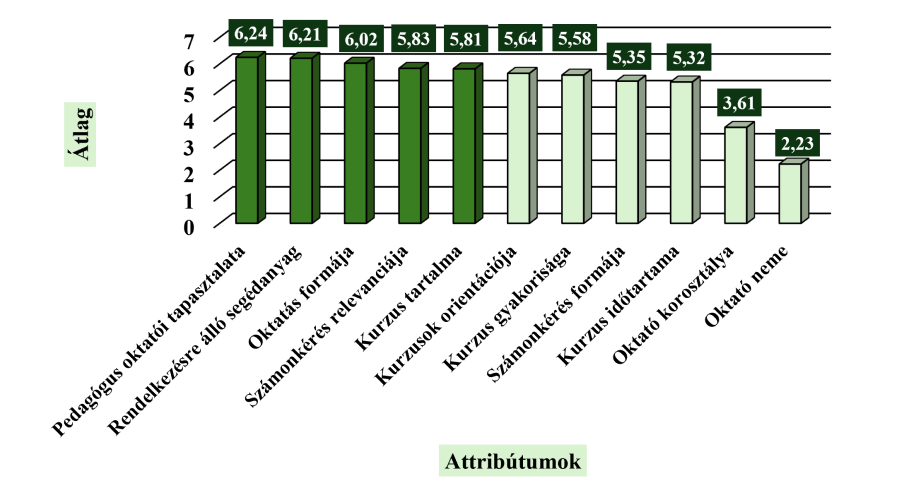
A kérdőívet 123 hallgató töltötte ki. Az egyes attribútumokra adott értékeléseket átlagoltuk, majd egy csökkenő sorrendet alakítottunk ki, melynek eredményeit az 1 ábra szemlélteti.
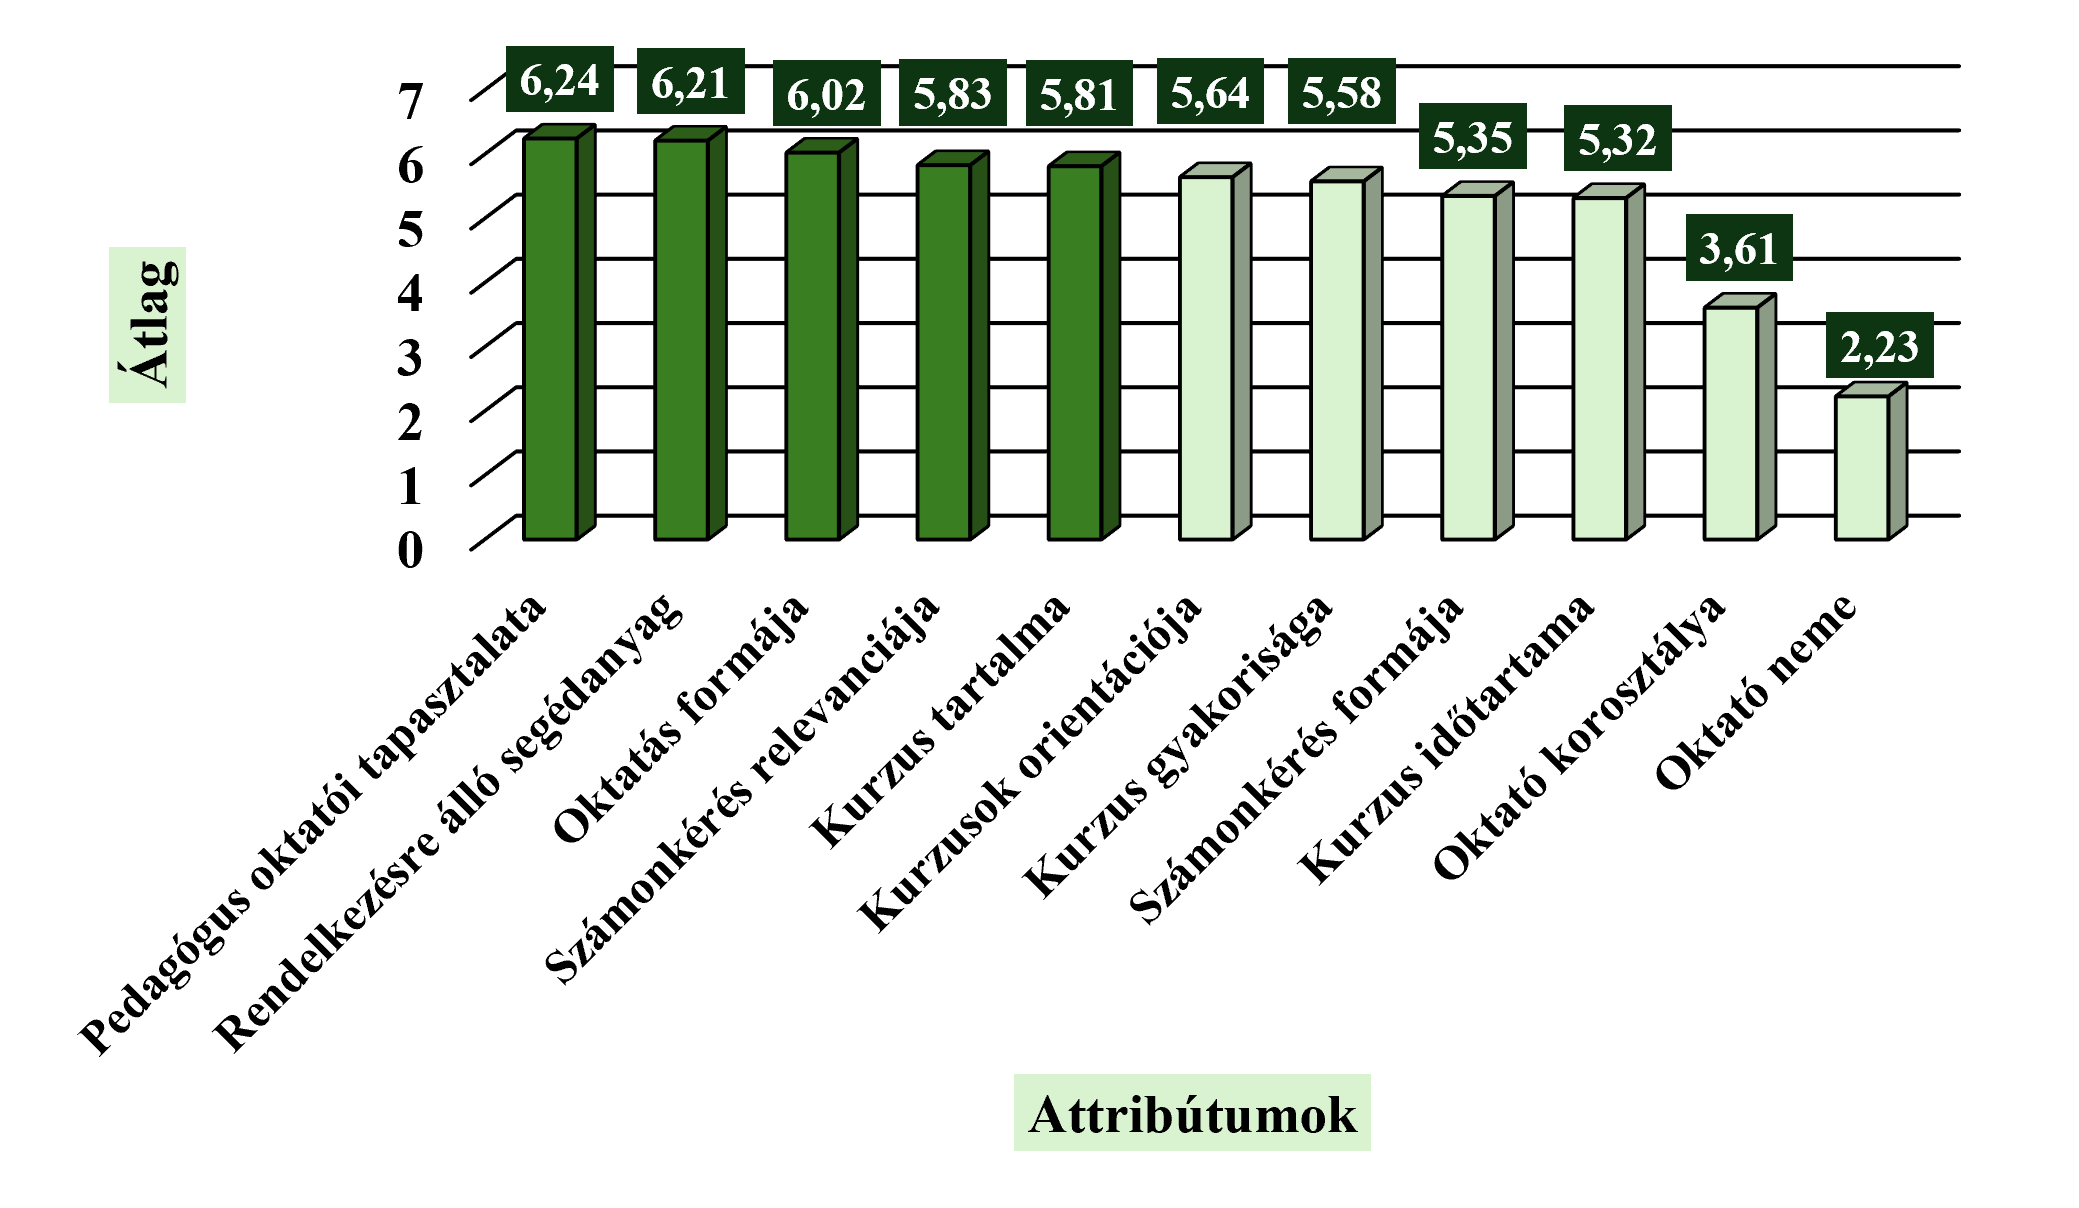
Bár a DCE-ben szereplő attribútumok számára nincs meghatározott korlát, kevesebbnek kell lennie 10-nél, így biztosítva a kitöltők kognitív terhelésének kezelhetőségét [19]. Ebből adódóan az 5 legmagasabb átlagértékkel rendelkező attribútumot vittük tovább a kutatásunk következő szakaszában. Ezek az attribútumok a következők: a pedagógus oktatói tapasztalata, a rendelkezésre álló segédanyag, az oktatás formája, a számonkérés relevanciája és a kurzus tartalma. Ezen attribútumokhoz szinteket határoztunk meg a DCE gyakorlatának megfelelően. Az egyes attribútumszintek meghatározását – az attribútumokhoz hasonlóan – szakirodalmi áttekintés alapján végeztük ([7], [15]). Az alternatívákat jellemző tulajdonságokat és azok szintjeit az 1. táblázatban foglaltuk össze. A fiktív helyzetek bemutatását megelőzően az attribútumok szintjeiről a döntési folyamat megkönnyítése végett az egyetemi hallgatók tájékoztatást kaptak.
| Tulajdonság | A tulajdonság szintje |
A tulajdonság leírása |
|---|---|---|
| Oktatói tapasztalat / rátermettség |
Didaktikus tanár | A tananyag érthető átadása [2]. |
| Tudós tanár | Elméleti fókusz, mély szaktudás [2]. | |
| Segédanyag | Biztosított | Elérhető tanulást segítő anyagok (jegyzet, dia). |
| Nem biztosított | Nem érhetőek el segédanyagok. | |
| Oktatás formája | Személyes | Kizárólag személyes jelenlét. |
| Online | Teljes egészében online. | |
| Hibrid | Személyes és online kombinációja. | |
| Számonkérés relevanciája |
Alacsony | Kevéssé kapcsolódik a tanult anyaghoz. |
| Közepes | Részben kapcsolódik. | |
| Magas | Szorosan illeszkedik a tanultakhoz. | |
| Kurzus tartalma | Alkalmazásokkal motivált gyakorlat | Gyakorlati példák és valós életbeli alkalmazások. |
| Elmélet tematikáját követő gyakorlat | A gyakorlat követi az elméleti anyagot. |
A DCE döntési helyzeteinek összeállításához a D-hatékony kísérleti elrendezési típust választottuk [27], melyet a Ngene 1.2 szoftverrel alakítottunk ki ([3], [6], [22]).
A végső kísérleti elrendezés 16 döntési helyzetből állt, melyek mindegyike 3 különböző kurzusopciót tartalmazott. Ezeket az opciókat a korábban ismertetett 5 tulajdonság bizonyos szintjei jellemeztek. Kettő blokkba rendeztük azokat, így az egyetemi hallgatóknak a döntési szituációk csak egy részhalmazával (8 helyzettel) kellett találkozniuk, elkerülve a szakirodalomban „fatigue effect” -ként említett torzító hatást, ami a döntési helyzetek irreálisan nagy számából eredhet ([5], [10]). A döntési helyzetre példát a 2. táblázat mutat. A kutatáshoz használt kérdőívek elérhetők az alábbi hivatkozásokon keresztül: Döntési helyzetek (I. blokk)és Döntési helyzetek (II. blokk).
| Kurzus_1 | Kurzus_2 | Kurzus_3 | |
|---|---|---|---|
| Oktatói tapasztalat / Rátermettség | Didaktikus tanár | Tudós tanár | Tudós tanár |
| Rendelkezésre álló segédanyag | Biztosított | Nem biztosított | Biztosított |
| Oktatás formája | Személyes | Online | Hibrid |
| Számonkérés relevanciája | Alacsony | Magas | Alacsony |
| Kurzus tartalma | Alkalmazásokkal motivált gyakorlat |
Elmélet tematikáját követő gyakorlat |
Alkalmazásokkal motivált gyakorlat |
A végső adatfelvétel 2025. 03. 26. – 04. 15. között történt papíralapú és online formában a Debreceni Egyetem Természettudományi és Technológiai Kar, Gazdaságtudományi Kar, Informatikai Kar, Mezőgazdaság-, és Élelmiszertudományi és Környezetgazdálkodási Kar, Bölcsészettudományi Kar, valamint a Nyíregyházi Egyetem Műszaki és Agrártudományi Intézet bevonásával. A kérdőív a következő szerkezeti egységekből állt:
-
A hallgatók tanulmányi háttéradatai: kar, szak és évfolyam megnevezése.
-
A diszkrét választási kísérlet döntési helyzetei: a kísérleti elrendezésnek megfelelően a hallgatók a két blokk egyikét (8 döntési szituációt) töltötték ki.
-
Demográfiai adatok: a hallgató neme, születési éve, legmagasabb iskolai végzettsége és lakóhelyének típusa.
3. Összefoglalás
Ebben a tanulmányban a diszkrét választási kísérlet (DCE) elméleti és matematikai hátterét,
valamint a matematikaoktatási kontextusra szabott kísérleti elrendezés módszertanát mutattuk
be. A szakirodalmi áttekintést és a pilot felmérést követően az eredetileg
meghatározott 14 attribútumból a hallgatók értékelései alapján az 5 legfontosabb
kurzusjellemzőt választottuk ki. A D-hatékony kísérleti elrendezés segítségével
megtervezett döntési szituációk, valamint a két kísérleti blokkba rendezett kérdőívek
biztosítják azt a módszertani keretet, amely alkalmas a hallgatói preferenciák
mérésére.
A kutatás következő fázisában elvégzett empirikus adatfelvétel
eredményeit, a feltételes logit modell becsült paramétereit, valamint a képzési területek
(közgazdász, tanár, STEM) közötti interakciós hatások elemzését a tanulmányunk II. részében
ismertetjük. A becsült modellek alapján levonható tanulságok célja, hogy gyakorlati és
oktatásmódszertani javaslatokat fogalmazzunk meg a jövőbeli felsőoktatási matematikakurzusok
megtervezéséhez és eredményességének növeléséhez.
Hivatkozások
[1] Aruvee, E., & Vintere, A. (2023). Overcoming mathematical anxiety to promote progress in mathematics during undergraduate engineering studies at university. In 22nd International Scientific Conference Engineering for Rural Development Proceedings (Vol. 22, pp. 1069–1074). https://doi.org/10.22616/ERDev.2023.22.TF227
[2] Bárdos, J. (2014-2015). A tanári lét dimenziói, különös tekintettel a tudós tanárokra (pedagógiai ars poetica). Pedagógusképzés, 12-13(41-42), 47-68. https://doi.org/10.37205/TEL-hun.2014-2015.03
[3] Bliemer, M. C. J., Rose, J. M., & Hess, S. (2008). Approximation of Bayesian efficiency in experimental choice designs. Journal of Choice Modelling, 1(1), 98–126. https://doi.org/10.1016/S1755-5345(13)70024-1
[4] Castillo, D., Carrión, J., Chamba, C., Jiménez-Gaona, Y., Rodríguez-Álvarez, M. J., & Lakshminarayanan, V. (2025). Didactic strategies for conceptual understanding and motivation in university mathematics: A systematic review. Frontiers in Education, 10, Article 1536470. https://doi.org/10.3389/feduc.2025.1536470
[5] Caussade, S., Ortúzar, J. de D., Rizzi, L. I., & Hensher, D. A. (2005). Assessing the influence of design dimensions on stated choice experiment estimates. Transportation Research Part B: Methodological, 39(7), 621–640. https://doi.org/10.1016/j.trb.2005.06.003
[6] ChoiceMetrics. (2018). Ngene 1.2 user manual & reference guide. http://files.choice-metrics.com/NgeneManual.pdf
[7] Cunningham, C. E., Deal, K., Neville, A., Rimas, H., & Lohfeld, L. (2006). Modeling the problem-based learning preferences of McMaster University undergraduate medical students using a discrete choice conjoint experiment. Advances in Health Sciences Education, 11(3), 245–266. https://doi.org/10.1007/s10459-006-0003-6
[8] Gonzalez-DeHass, A. R., Furner, J. M., Vásquez-Colina, M. D., & Morris, J. D. (2024). Undergraduate students’ math anxiety: The role of mindset, achievement goals, and parents. International Journal of Science and Mathematics Education, 22(5), 1037–1056. https://doi.org/10.1007/s10763-023-10416-4
[9] Günthel, D., Strum, L., & Gärtner, C. (2009). Anwendung der Choice-Based-Conjoint-Analyse zur Prognose von Kaufentscheidungen im ÖPNV (Diskussionsbeiträge aus dem Institut für Wirtschaft und Verkehr, No. 1/2009). Technische Universität Dresden. https://hdl.handle.net/10419/29683
[10] Hensher, D. A. (2006). How do respondents process stated choice experiments? Attribute consideration under varying information load. Journal of Applied Econometrics, 21(6), 861–878. https://doi.org/10.1002/jae.877
[11] Hess, S., & Palma, D. (2019). Apollo: A flexible, powerful and customisable freeware package for choice model estimation and application. Journal of Choice Modelling, 32, Article 100170. https://doi.org/10.1016/j.jocm.2019.100170
[12] Hess, S., & Palma, D. (2021). Apollo version 0.2.4 – User manual. Apollo Choice Modelling. http://www.apollochoicemodelling.com
[13] Hillig, T. (2006). Verfahrensvarianten der Conjoint-Analyse zur Prognose von Kaufentscheidungen: Eine Monte-Carlo-Simulation. Deutscher Universitätsverlag. https://doi.org/10.1007/978-3-8350-9006-4
[14] Johnson, P., Rowlett, P., & Shukie, A. (2025). On the value of context in engineering mathematics problems: students’ perspectives. Teaching Mathematics and its Applications: An International Journal of the IMA, 44(4), 311–326. https://doi.org/10.1093/teamat/hraf004
[15] Kennelly, B., Flannery, D., Considine, J., Doherty, E., & Hynes, S. (2014). Modelling the preferences of students for alternative assignment designs using the discrete choice experiment methodology. Practical Assessment, Research, and Evaluation, 19(16), 1–13. https://doi.org/10.7275/y9r2-nc06
[16] Klymchuk, S., & Spooner, K. (2020). University students’ preferences for application problems and pure mathematics questions, Teaching Mathematics and Its Applications, 39, 29–37, https://doi.org/10.1093/teamat/hry014
[17] Koppelman, F. S., & Bhat, C. (2006). A self instructing course in mode choice modeling: Multinomial and nested logit models. U.S. Department of Transportation, Federal Transit Administration.
[18] Marschak, J. (1974). Binary-choice constraints and random utility indicators. In Economic information, decision, and prediction (Theory and Decision Library, Vol. 7/1, pp. 110–129). Springer. https://doi.org/10.1007/978-94-010-9276-0_9
[19] Marshall, D., Bridges, J. F. P., Hauber, B., Cameron, R., Donnalley, L., Fyie, K., & Johnson, F. R. (2010). Conjoint analysis applications in health: How are studies being designed and reported? Patient: Patient-Centered Outcomes Research, 3(4), 249–256. https://doi.org/10.2165/11539650-000000000-00000
[20] Pho, K.-H., Ly, S., Nguyen, T. T., & Lukusa, T. M. (2019). Comparison among Akaike Information Criterion, Bayesian Information Criterion and Vuong’s test in model selection: A case study of violated speed regulation in Taiwan. Journal of Advanced Engineering and Computation, 3(1), 293–303. https://doi.org/10.25073/jaec.201931.220
[21] R Core Team. (2020). R: A language and environment for statistical computing. R Foundation for Statistical Computing. https://www.R-project.org/
[22] Rose, J. M., & Bliemer, M. C. J. (2009). Constructing efficient stated choice experimental designs. Transport Reviews, 29(5), 587–617. https://doi.org/10.1080/01441640902827623
[23] Sung, M.-C., McDonald, D. C. J., & Johnson, J. E. V. (2016). Probabilistic forecasting with discrete choice models: Evaluating predictions with pseudo-coefficients of determination. European Journal of Operational Research, 248(3), 1021–1030. https://doi.org/10.1016/j.ejor.2015.08.068
[24] Train, K. E. (2009). Discrete choice methods with simulation (2nd ed.). Cambridge University Press. https://doi.org/10.1017/CBO9780511805271
[25] Yamani, M., Almala, A., Elbedour, S., Woodson, K., & Reed, G. (2018). Math anxiety: Trends, issues and challenges. Journal of Psychology and Clinical Psychiatry, 9(1), 1–12.
[26] Viholainen, A., Tossavainen, T., & Gröhn, J. (2023). Epistemological beliefs, motivational values, and study habits among students of tertiary mathematics. EURASIA Journal of Mathematics, Science and Technology Education. 19(5), Article em2269. https://doi.org/10.29333/ejmste/13163
[27] Walker, J. L., Wang, Y., Thorhauge, M., & Ben-Akiva, M. (2018). D-efficient or deficient? A robustness analysis of stated choice experimental designs. Theory and Decision, 84(2), 215–238. https://doi.org/10.1007/s11238-017-9647-3
[28] Wang, C., Cho, H. J., Wiles, B., Moss, J. D., Bonem, E. M., Li, Q., Lu, Y., & Levesque-Bristol, C. (2022). Competence and autonomous motivation as motivational predictors of college students’ mathematics achievement: From the perspective of self-determination theory. International Journal of STEM Education, 9, Article 41. https://doi.org/10.1186 s40594-022-00359-7
Czine Péter
Debreceni Egyetem, GTK, Társadalomtudományi Kutatási Koordinációs Központ;
Figula Ágota
Debreceni Egyetem, TTK, Matematikai Intézet;
Silling Szintia Adriána
Debreceni Egyetem, GTK, Vezetés és szervezés szakos MSc hallgató